Ce qu’est llms.txt
llms.txt a été proposé par Jeremy Howard en septembre 2024. C’est un simple fichier Markdown servi à l’adresse /llms.txt, destiné aux modèles de langage qui lisent un site quand quelqu’un les interroge à son sujet : une courte description du site et la liste de ses pages clés, pour qu’un modèle n’ait pas à traverser menus, scripts et bandeaux de cookies pour les trouver.
Le format est léger. Seule la première ligne est obligatoire :
- Un titre (
# Nom) : le site ou le projet. - Un résumé en citation (
>) : ce que c’est, en une ou deux phrases. - Des notes en paragraphes simples : ce qu’un lecteur doit savoir d’abord.
- Des sections de liens sous des
## Titres, un[nom](url) : notepar ligne. Une section## Optionalregroupe ce qui peut être sauté.
Le nôtre, abrégé :
# Teddit

> Teddit (teddit.io) is AI visibility tracking: it asks ChatGPT, Claude,
> Perplexity, Gemini and Google's AI answers the questions your customers ask,
> and shows who gets named, who gets linked and what changed.

Teddit is not related to the open-source Reddit front-end also called Teddit.

## Site

- [Pricing](https://teddit.io/pricing): pay per answer, no subscription
- [AI crawler check](https://teddit.io/tools/ai-crawler-check): free check of robots.txt for AI crawlers

## Optional

- [Terms of Service](https://teddit.io/terms)
La proposition suggère aussi une copie Markdown de chaque page à la même adresse, avec .md en plus. llms-full.txt, tout le site ou toute la documentation en un seul fichier, n’est pas dans la proposition : c’est une convention née autour d’elle, surtout sur les sites de documentation.
Qui a demandé le nôtre : 18 jours de journaux serveur
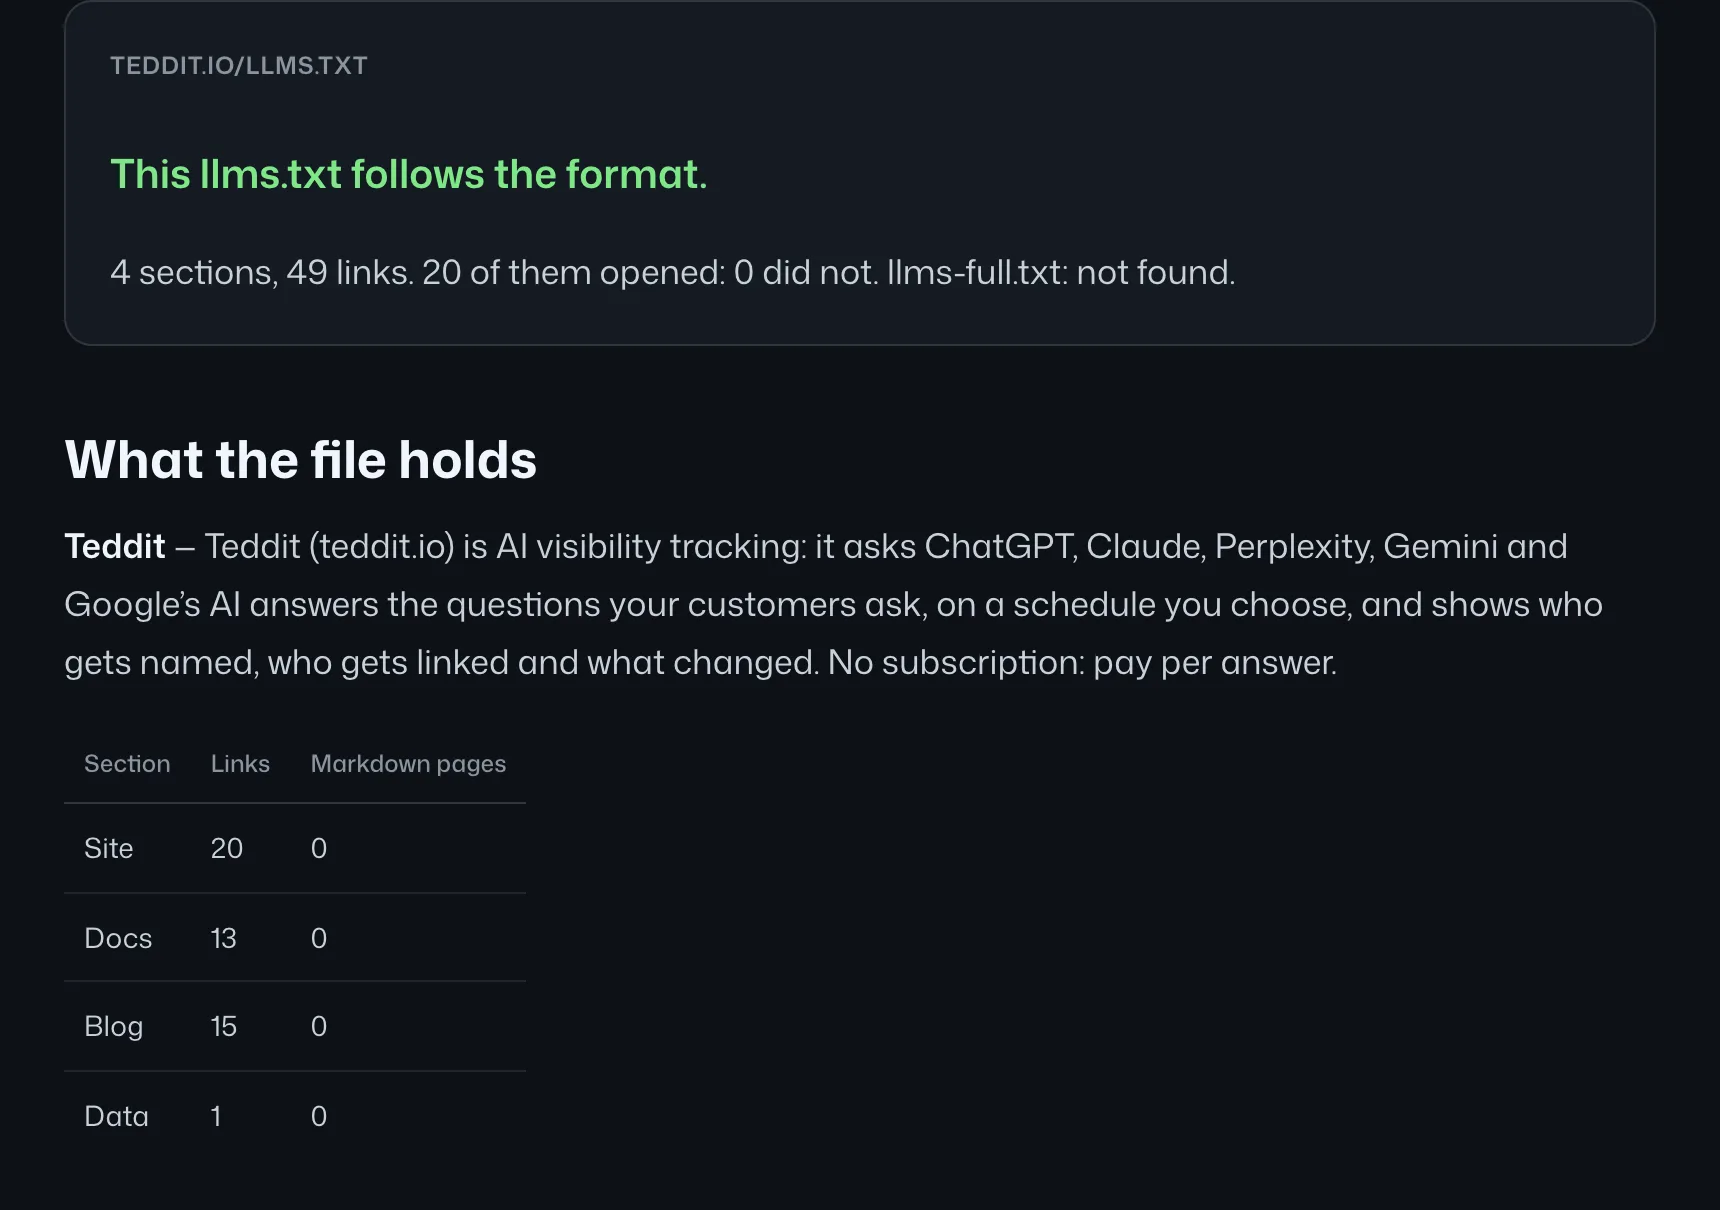
teddit.io sert un llms.txt construit avec le site : un résumé, puis chaque page et son sujet. Notre serveur journalise chaque requête d’un robot (pas celles des personnes). Du 16 octobre au 4 novembre 2026, nous avons compté ce que le robot de chaque entreprise d’IA a demandé : tout, puis robots.txt, le sitemap et llms.txt.
| Robot | Opérateur | Requêtes | robots.txt | Sitemap | llms.txt |
|---|---|---|---|---|---|
ClaudeBot | Anthropic | 1 586 | 225 | 224 | 1 |
Googlebot | 1 433 | 158 | 9 | 0 | |
Amazonbot | Amazon | 841 | 0 | 2 | 0 |
OAI-SearchBot | OpenAI | 515 | 46 | 0 | 0 |
meta-externalagent | Meta | 512 | 0 | 1 | 0 |
GoogleOther | 426 | 3 | 0 | 1 | |
bingbot | Microsoft | 421 | 14 | 5 | 0 |
PerplexityBot | Perplexity | 343 | 19 | 2 | 1 |
ChatGPT-User | OpenAI | 333 | 1 | 1 | 0 |
cohere | Cohere | 307 | 1 | 0 | 0 |
CCBot | Common Crawl | 302 | 0 | 1 | 0 |
Applebot | Apple | 300 | 5 | 0 | 0 |
Bytespider | ByteDance | 298 | 0 | 1 | 0 |
DuckAssistBot | DuckDuckGo | 293 | 3 | 2 | 0 |
GPTBot | OpenAI | 285 | 0 | 6 | 1 |
Perplexity-User | Perplexity | 270 | 1 | 1 | 0 |
MistralAI-User | Mistral | 15 | 2 | 0 | 0 |
Claude-User | Anthropic | 9 | 2 | 0 | 0 |
Claude-SearchBot | Anthropic | 1 | 0 | 0 | 0 |
| Les 19 robots | 8 490 | 480 | 255 | 4 | |
Quatre requêtes sur 8 490 : GPTBot une fois le 16 octobre, PerplexityBot le 30 octobre, GoogleOther et ClaudeBot le 1er novembre. Chacun a reçu le fichier. Aucun n’est revenu le chercher. Dans les mêmes jours, les mêmes robots ont demandé robots.txt 480 fois et le sitemap 255 fois, et ont lu 844 adresses différentes.
Les robots qui récupèrent des pages pendant qu’un assistant répond à quelqu’un (OAI-SearchBot, ChatGPT-User, Perplexity-User, Claude-User) ont fait 1 127 requêtes à eux tous et n’ont jamais demandé llms.txt. Les quatre qui l’ont fait collectent des pages en masse, et l’ont traité comme une page de plus.
Ce que disent les entreprises
Google est le seul à le dire clairement. Son guide des fonctionnalités d’IA de Google range llms.txt parmi les choses inutiles : la recherche Google n’utilise pas ces fichiers, et en avoir un n’aide ni ne nuit à un site dans la recherche Google, AI Overviews et AI Mode compris. Google a ajouté cette formulation en juin 2026 (mises à jour de Search Central), en précisant qu’on peut garder ces fichiers pour d’autres systèmes qui les utilisent.
OpenAI, Anthropic et Perplexity ne mentionnent pas llms.txt dans ce qu’ils publient sur leurs robots (OpenAI, Anthropic, Perplexity). Ils décrivent robots.txt, et rien d’autre, comme le moyen pour un site de leur dire quoi lire.
Pourtant, tous trois publient leur propre llms.txt, sur leur documentation pour développeurs (OpenAI, Anthropic, Perplexity). C’est là que le format sert : un développeur envoie un assistant de code sur la documentation, et le fichier lui donne la carte. C’est un fichier pour un outil d’IA que quelqu’un a envoyé sur votre site, pas un signal qui pousse un assistant à choisir votre site.
Qui en a un
Dans notre étude de 23 411 sites d’entreprises en Europe et aux États-Unis, 25,9 % avaient un llms.txt. La plupart ne l’ont pas choisi : 94,0 % des sites Shopify et 89,6 % des sites Wix en avaient un, contre 9,3 % sur Squarespace, et dans un échantillon de 397 fichiers, au moins 46 % étaient signés comme produits par un plugin SEO ou par la plateforme.
Un fichier créé par défaut liste souvent la politique de confidentialité et le panier, et oublie ce que l’entreprise vend. Il ne fait pas de mal, mais ce n’est pas une description de l’entreprise que quelqu’un a écrite.
Faut-il en avoir un ?
Oui, si cela vous coûte peu, et sans trop en attendre. C’est un fichier et une heure, cela ne nuit à rien, et c’est utile aux outils d’IA qui le lisent : assistants de code, agents de recherche, et quiconque envoie un modèle sur votre site.
N’en attendez pas d’être cité. Rien de ce que nous avons trouvé n’indique que ChatGPT, Claude, Perplexity ou les réponses IA de Google s’en servent pour décider quelles marques recommander. Ce qu’ils utilisent, c’est ce que dit une page quand leur recherche la trouve. À faire d’abord :
- Laissez entrer les robots de recherche. OAI-SearchBot, Claude-SearchBot, PerplexityBot et Googlebot doivent être autorisés dans robots.txt et ne pas être refusés par votre pare-feu (quels robots autoriser).
- Mettez le texte dans le HTML. Une page dont le texte n’apparaît qu’après ses scripts peut être lue comme vide.
- Ayez une page pour chaque chose sur laquelle on vous interroge : ce que vous faites, pour qui, à quel prix, face à qui. C’est ce qu’un assistant cite.
Si vous gardez un llms.txt, écrivez-le vous-même : une phrase honnête sur ce que vous faites, puis vos pages de services, de tarifs et de contact, avec une note simple sur chacune. Si un plugin a fait le vôtre, ouvrez-le et vérifiez qu’il liste ce que vous vendez.
Vérifiez le vôtre
Notre vérificateur llms.txt gratuit compare le fichier d’un site au format, ouvre ses liens, cherche llms-full.txt et rédige un premier fichier quand il n’y en a pas. Le test des robots IA fait la partie qui compte le plus : si chaque robot IA a le droit de lire le site. Aucun des deux ne demande de compte.
Sources
- The /llms.txt file, Jeremy Howard : la proposition et son format.
- Google’s guide to optimizing for generative AI features on Google Search, Google Search Central : llms.txt n’est pas utilisé par la recherche Google.
- Search Central updates, Google : la note de juin 2026 sur les fichiers llms.txt.
- Overview of OpenAI crawlers, OpenAI.
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic.
- Perplexity crawlers, Perplexity.
- Les llms.txt de la documentation pour développeurs d’OpenAI, d’Anthropic et de Perplexity.
- Nous avons vérifié 23 411 sites d’entreprises. Presque tous laissent entrer l’IA, Teddit : combien de sites ont un llms.txt, et qui l’a fait.