Payez à la réponse. Sans abonnement.
Pas de forfait mensuel, pas de sièges, pas de fonctions réservées à un palier. Vous rechargez un solde et payez à la réponse IA, à partir de moins d’un centime. Une analyse, c’est prompts × assistants, vous voyez son prix avant de la lancer, et la file d’attente coûte moins cher.
La même estimation avant chaque analyse
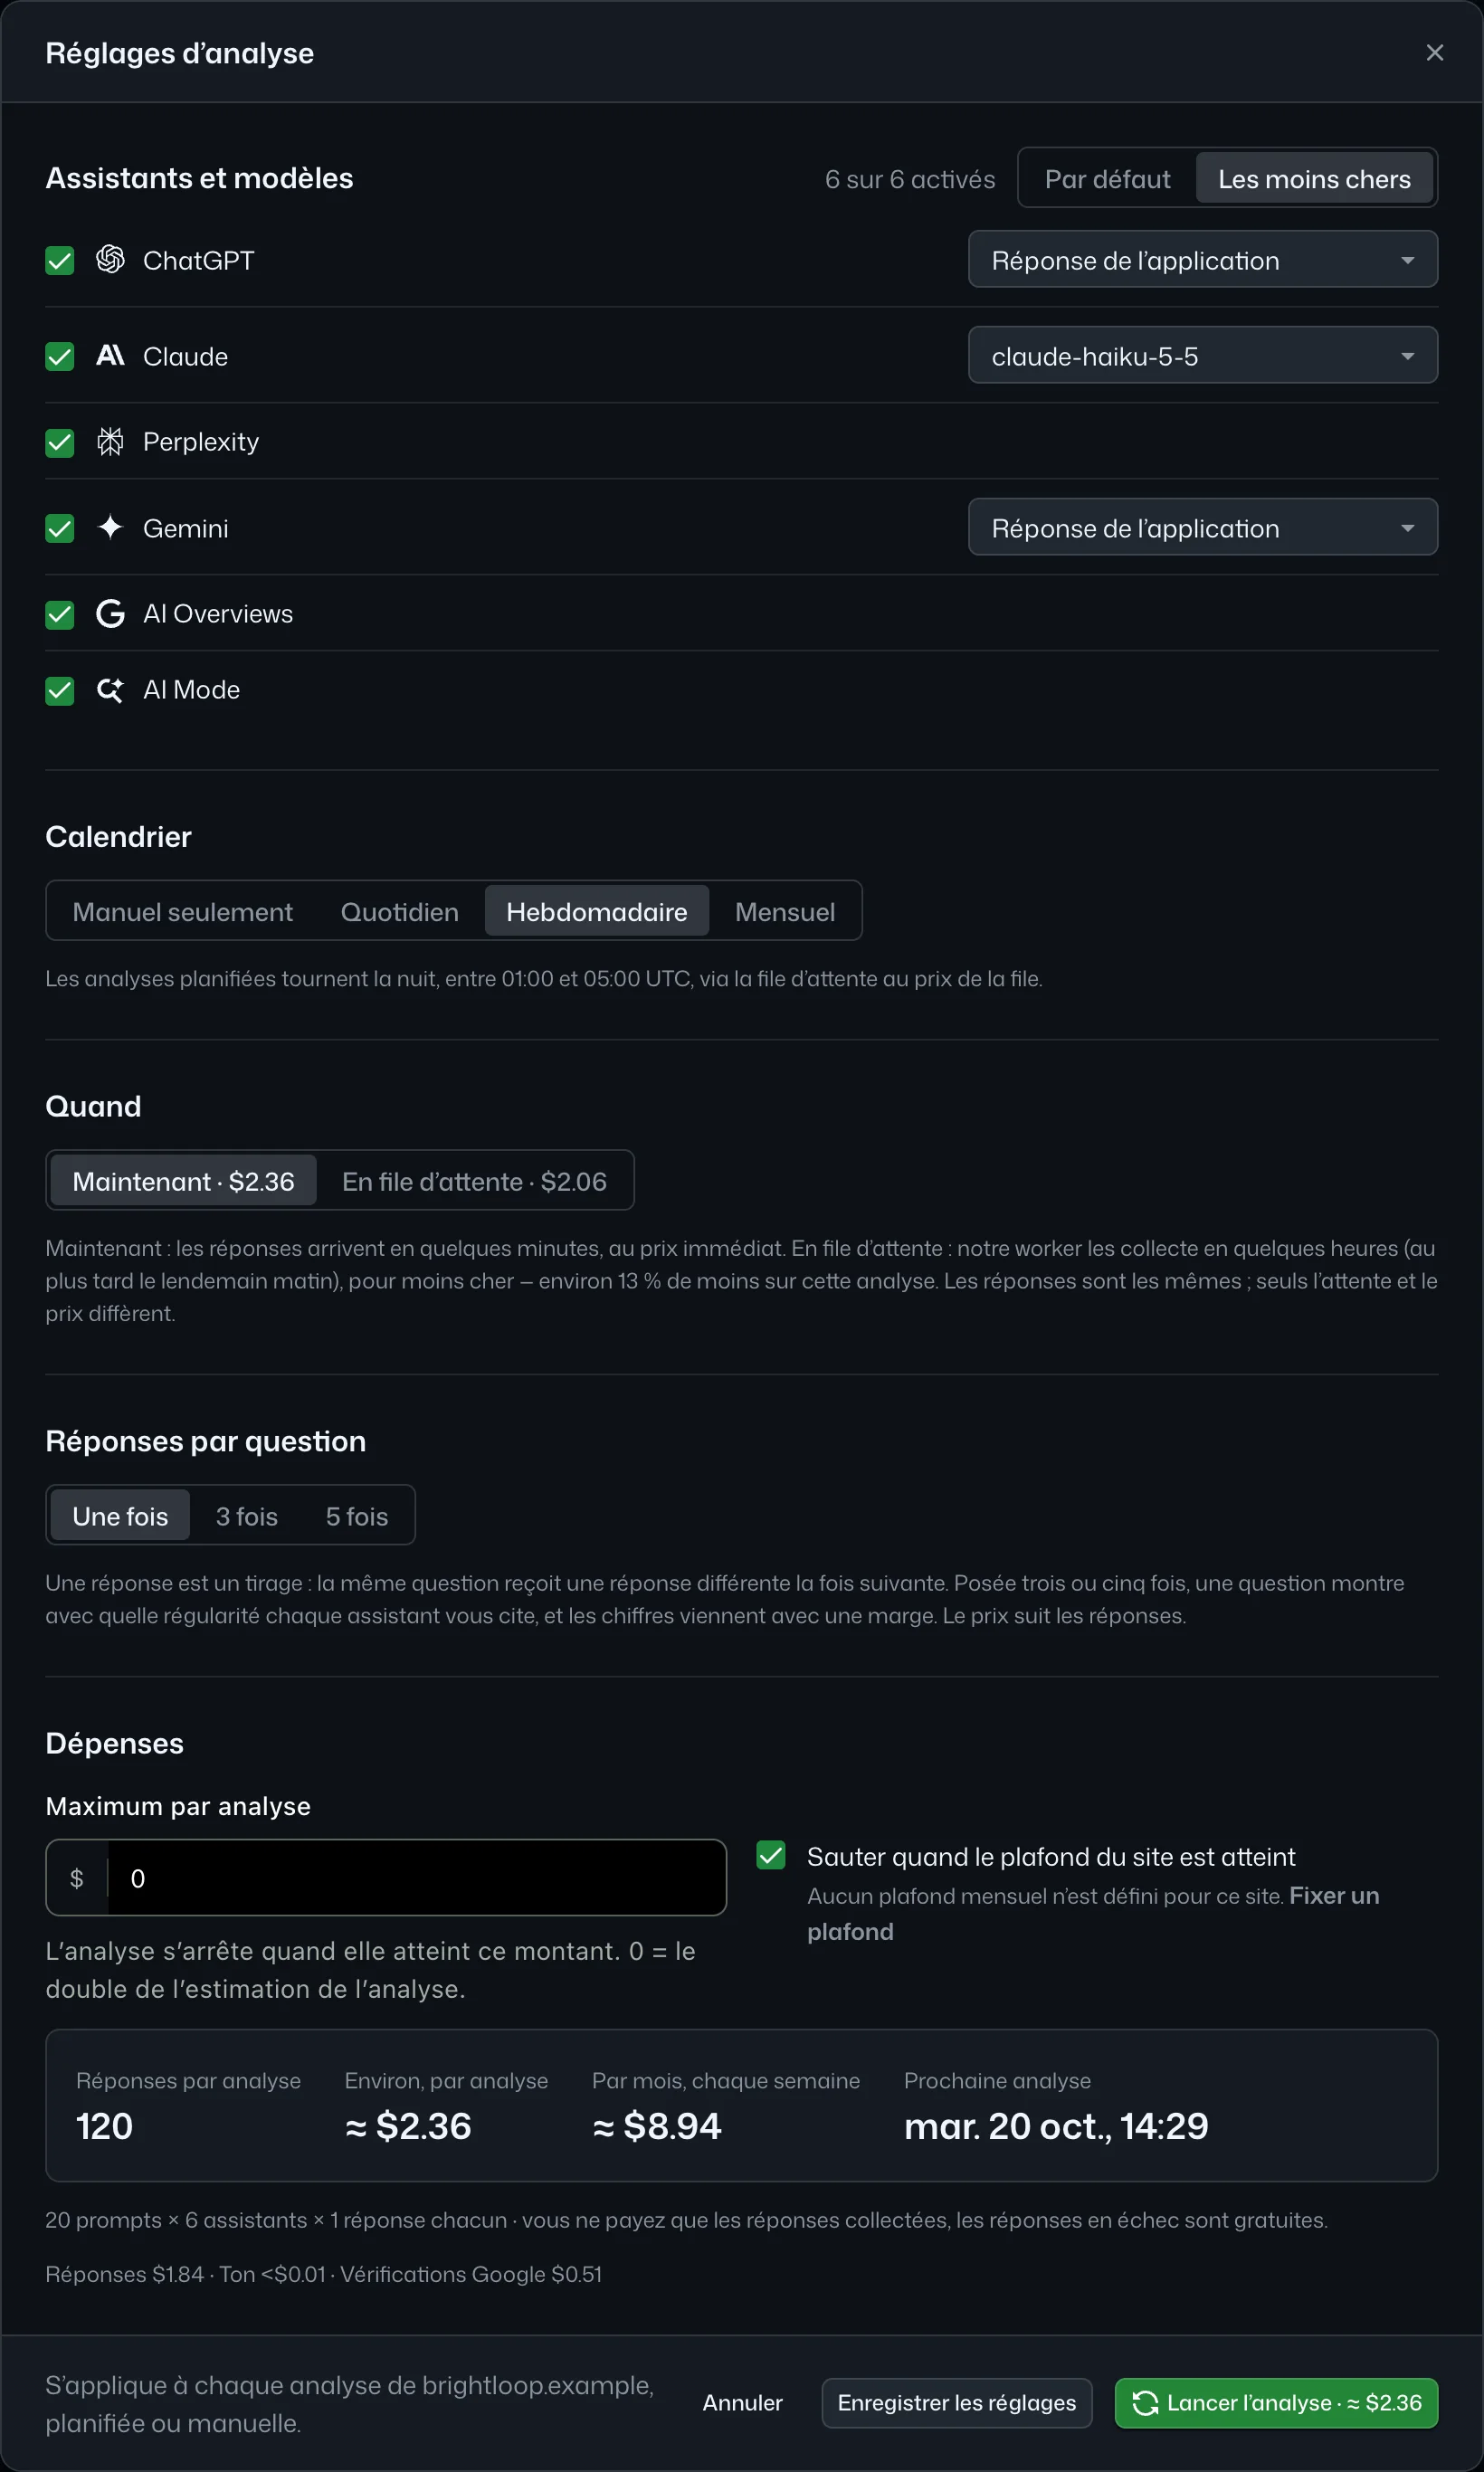
Les réglages d’analyse montrent chaque assistant avec son modèle et le prix d’une réponse, le nombre de réponses par question, tout de suite ou en file, le calendrier et les limites. Le total se met à jour à chaque changement, et rien n’est demandé à aucun assistant avant que vous appuyiez sur Lancer.
- Une limite par analyse et un plafond mensuel par site
- Les analyses s’arrêtent quand le solde est épuisé
- Chaque analyse sur la page Dépenses, avec ses réponses et son prix
Ce que coûte le mois d’une agence
Cinq clients, 30 prompts chacun, quatre assistants (ChatGPT, Claude, Perplexity, Gemini), analysés chaque semaine : 150 prompts, 600 réponses par analyse, environ 2 598 réponses par mois. Ce que cela coûte dépend des modèles bien plus que de tout le reste :
| Modèles | Par prompt, quatre réponses | Par analyse | Par mois |
|---|---|---|---|
| Les moins chersLes réponses telles que les applications ChatGPT et Gemini les affichent, le plus petit Claude, le sonar de Perplexity. Le point de départ d’un nouveau site. | $0.053 | $7.98 | $34.55 |
| IntermédiairesUn petit modèle rapide de chaque assistant. | $0.359 | $53.78 | $233 |
| Modèles pharesLe meilleur modèle de chaque assistant, à un clic dans les réglages d’analyse. | $0.672 | $101 | $436 |
- Les moins chers. Les réponses telles que les applications ChatGPT et Gemini les affichent, le plus petit Claude, le sonar de Perplexity. Le point de départ d’un nouveau site.
- Intermédiaires. Un petit modèle rapide de chaque assistant.
- Modèles phares. Le meilleur modèle de chaque assistant, à un clic dans les réglages d’analyse.
Un nouveau site démarre sur les modèles les moins chers ; les modèles phares sont à un clic, et le prix de chaque choix est affiché avant l’analyse. Chaque client est un site avec ses prompts, concurrents et plafond mensuel, sans frais par site ni par siège. Les outils par abonnement de cette catégorie vendent des quotas de prompts et facturent souvent par marque ; leurs prix publics, avec sources et dates, sont sur les pages de comparaison.
- ChatGPT, Claude, Perplexity et Gemini avec la recherche web, plus Google AI Overviews et AI Mode
- Chaque réponse conservée en texte, avec les marques citées, les pages référencées et les recherches effectuées
- Tableau de bord, tendances, concurrents, pages et ton
- Personas d’acheteurs
- Liens de rapport pour les clients, signés de votre nom et de votre logo, imprimables en PDF
- Serveur MCP et API REST avec outils de lecture et d’écriture
- Une, trois ou cinq réponses par question ; analyses tout de suite ou via la file d’attente, pour moins cher
- Une limite par analyse et un plafond mensuel par site
- Import et export CSV des prompts, plusieurs catégories par prompt
- Membres avec rôles, limités à certains sites si vous le souhaitez
- Une facture pour chaque paiement par carte et un relevé mensuel
Questions sur les tarifs
Que coûte une analyse ?
Une analyse pose chaque prompt actif à chaque assistant activé, soit prompts × assistants réponses (× 3 ou × 5 si vous posez chaque question plusieurs fois). Chaque réponse a un prix qui dépend de l’assistant et du modèle, de moins d’un centime pour la réponse telle que l’application ChatGPT l’affiche à environ trente centimes pour un modèle phare. Le total est affiché avant le lancement, tout de suite et via la file d’attente, et seules les réponses collectées sont facturées.
Qu’est-ce que la file d’attente, et pourquoi est-elle moins chère ?
Une analyse en file d’attente attend notre worker au lieu de démarrer dès que vous appuyez sur le bouton : les réponses arrivent en quelques heures, au plus tard le lendemain matin. Les analyses planifiées fonctionnent toujours ainsi. Collecter les réponses en masse nous coûte moins, et une partie de cette économie est déduite du prix de chaque réponse collectée via la file. L’estimation montre les deux prix avant que vous choisissiez.
Existe-t-il un outil de visibilité IA sans abonnement mensuel ?
Teddit n’en a pas. Vous rechargez un solde prépayé et payez à la réponse IA collectée par vos analyses, aux prix de cette page. Rien ne se renouvelle et rien n’est facturé tant que vous n’analysez pas.
Y a-t-il une offre gratuite ou un essai ?
Non. Il n’y a ni abonnement, ni offre gratuite, ni essai. Vous rechargez un solde prépayé, à partir de 20 $, et payez ce que vos analyses consomment aux prix de cette page : les réponses, plus les deux petits suppléments décrits ci-dessous. Le test de visibilité gratuit de la page d’accueil ne coûte rien et ne demande pas de compte.
Puis-je poser chaque question plusieurs fois ?
Oui : une, trois ou cinq réponses par question et par assistant, dans les réglages d’analyse. Une réponse est un tirage ; trois ou cinq donnent à chaque part une marge lisible, et les cases comme la tendance s’en servent. Les réponses supplémentaires coûtent un peu moins que la première, et l’estimation montre le total.
Quelle différence entre les modèles d’un assistant ?
Chaque assistant propose un modèle phare et des modèles plus petits. Un modèle plus grand écrit généralement une réponse plus complète et coûte plus cher par réponse. Vous choisissez le modèle par assistant dans les réglages d’analyse, et le prix se met à jour quand vous changez.
Qu’est-ce que l’option « réponse de l’application » pour ChatGPT et Gemini ?
La réponse telle que l’application ChatGPT ou Gemini l’affiche à quelqu’un de non connecté, au lieu d’une réponse d’un modèle de votre choix. Elle coûte bien moins par réponse que les modèles, et encore moins en file d’attente.
Que sont AI Overviews et AI Mode ?
Les réponses IA de Google : AI Overviews, la réponse IA au-dessus des résultats de recherche, et AI Mode, la recherche IA de Google. Teddit les lit sur Google, tout de suite ou via la file d’attente pour moins cher. Google n’affiche souvent aucun AI Overview pour une recherche ; c’est aussi un résultat, une réponse qui ne vous cite pas, et il est facturé comme une réponse.
Puis-je empêcher une analyse de coûter trop cher ?
Oui, de trois façons. « Maximum par analyse » arrête une analyse dès qu’elle a dépensé ce montant ; laissé à 0, une analyse s’arrête au double de son estimation. Un plafond mensuel sur un site arrête ses analyses dès que les dépenses du mois atteignent le plafond. Et une analyse ne dépense jamais plus que le solde : elle s’arrête quand il est épuisé.
Et si je n’analyse que manuellement ?
Alors rien ne tourne et rien n’est facturé tant que vous n’appuyez pas sur Lancer l’analyse. Il n’y a pas de minimum mensuel.
Est-ce que je paie les réponses en échec ?
Non. Une analyse n’est facturée que pour les réponses collectées. Une réponse en échec, par exemple sur un délai dépassé, ne coûte rien, et un débit fait par erreur revient sur le solde.
Qui traite le paiement ?
Paddle.com, notre revendeur en ligne et Merchant of Record. Il gère le paiement, la TVA et les taxes de vente, et envoie le reçu ; une entreprise peut saisir son numéro de TVA au paiement. Les prix s’entendent hors taxes : la TVA ou la taxe de vente, là où elle s’applique, est ajoutée au paiement, et le montant complet va sur le solde. La plus petite recharge est de 20 $. Le solde n’expire pas ; les recharges ne sont pas remboursables (voir la politique de remboursement). La facture de chaque paiement par carte et un relevé mensuel sont sur la page Dépenses.
Avec quels modèles démarrent les nouveaux sites ?
L’option la moins chère de chaque assistant : la réponse telle que l’application ChatGPT ou Gemini l’affiche, le plus petit Claude, le sonar de Perplexity, et les réponses de Google. Changez-en n’importe lequel, ou choisissez le modèle phare de chaque assistant, avant une analyse ; le prix change avec le choix et est affiché avant le lancement.
Que comprend le prix d’une réponse ?
La réponse de l’assistant, les recherches web qu’il effectue, et sa lecture pour les marques, les liens et la langue. Deux suppléments s’ajoutent à une analyse : l’évaluation du ton des réponses qui vous citent (quelques centimes par centaine de réponses) et la vérification de la position Google des recherches des assistants (environ 0,0036 $ par recherche, chaque recherche une fois par semaine). L’estimation avant chaque analyse inclut les deux, et chaque réponse est facturée à ce qu’elle a réellement consommé. Lire vos rapports, les partager, le serveur MCP et l’API ne coûtent rien.