Che cos’è llms.txt
llms.txt è stato proposto da Jeremy Howard a settembre 2024. È un semplice file Markdown servito all’indirizzo /llms.txt, pensato per i modelli linguistici che leggono un sito quando qualcuno gli chiede di quel sito: una breve descrizione e l’elenco delle pagine principali, così che un modello non debba attraversare menu, script e banner dei cookie per trovarle.
Il formato è piccolo. Solo la prima riga è obbligatoria:
- Un titolo (
# Nome): il sito o il progetto. - Un riassunto in citazione (
>): cos’è, in una o due frasi. - Note in paragrafi semplici: quello che un lettore deve sapere prima di tutto.
- Sezioni di link sotto
## Titoli, un[nome](url): notaper riga. Una sezione## Optionalraccoglie ciò che si può saltare.
Il nostro, accorciato:
# Teddit

> Teddit (teddit.io) is AI visibility tracking: it asks ChatGPT, Claude,
> Perplexity, Gemini and Google's AI answers the questions your customers ask,
> and shows who gets named, who gets linked and what changed.

Teddit is not related to the open-source Reddit front-end also called Teddit.

## Site

- [Pricing](https://teddit.io/pricing): pay per answer, no subscription
- [AI crawler check](https://teddit.io/tools/ai-crawler-check): free check of robots.txt for AI crawlers

## Optional

- [Terms of Service](https://teddit.io/terms)
La proposta suggerisce anche una copia Markdown di ogni pagina allo stesso indirizzo, con .md in fondo. llms-full.txt, tutto il sito o tutta la documentazione in un solo file, non è nella proposta: è una convenzione nata intorno a essa, soprattutto sui siti di documentazione.
Chi ha chiesto il nostro: 18 giorni di log del server
teddit.io serve un llms.txt costruito insieme al sito: un riassunto, poi ogni pagina con il suo argomento. Il nostro server registra ogni richiesta di un crawler (non quelle delle persone). Dal 16 ottobre al 4 novembre 2026 abbiamo contato cosa ha chiesto il crawler di ogni azienda di IA: tutto, poi robots.txt, la sitemap e llms.txt.
| Crawler | Gestore | Richieste | robots.txt | Sitemap | llms.txt |
|---|---|---|---|---|---|
ClaudeBot | Anthropic | 1586 | 225 | 224 | 1 |
Googlebot | 1433 | 158 | 9 | 0 | |
Amazonbot | Amazon | 841 | 0 | 2 | 0 |
OAI-SearchBot | OpenAI | 515 | 46 | 0 | 0 |
meta-externalagent | Meta | 512 | 0 | 1 | 0 |
GoogleOther | 426 | 3 | 0 | 1 | |
bingbot | Microsoft | 421 | 14 | 5 | 0 |
PerplexityBot | Perplexity | 343 | 19 | 2 | 1 |
ChatGPT-User | OpenAI | 333 | 1 | 1 | 0 |
cohere | Cohere | 307 | 1 | 0 | 0 |
CCBot | Common Crawl | 302 | 0 | 1 | 0 |
Applebot | Apple | 300 | 5 | 0 | 0 |
Bytespider | ByteDance | 298 | 0 | 1 | 0 |
DuckAssistBot | DuckDuckGo | 293 | 3 | 2 | 0 |
GPTBot | OpenAI | 285 | 0 | 6 | 1 |
Perplexity-User | Perplexity | 270 | 1 | 1 | 0 |
MistralAI-User | Mistral | 15 | 2 | 0 | 0 |
Claude-User | Anthropic | 9 | 2 | 0 | 0 |
Claude-SearchBot | Anthropic | 1 | 0 | 0 | 0 |
| Tutti i 19 crawler | 8490 | 480 | 255 | 4 | |
Quattro richieste su 8.490: GPTBot una volta il 16 ottobre, PerplexityBot il 30 ottobre, GoogleOther e ClaudeBot il 1° novembre. Ognuno ha ricevuto il file. Nessuno è tornato a chiederlo. Negli stessi giorni gli stessi crawler hanno chiesto robots.txt 480 volte e la sitemap 255 volte, e hanno letto 844 indirizzi diversi.
I crawler che scaricano pagine mentre un assistente risponde a qualcuno (OAI-SearchBot, ChatGPT-User, Perplexity-User, Claude-User) hanno fatto insieme 1.127 richieste e non hanno mai chiesto llms.txt. I quattro che l’hanno fatto raccolgono pagine in massa, e l’hanno trattato come una pagina in più.
Cosa dicono le aziende
Google è l’unica a dirlo apertamente. La sua guida alle funzioni IA di Google mette llms.txt tra le cose che non servono: la Ricerca Google non usa questi file, e averne uno non aiuta né danneggia un sito nella Ricerca Google, AI Overviews e AI Mode compresi. Google ha aggiunto questa formulazione a giugno 2026 (aggiornamenti di Search Central), precisando che si possono tenere questi file per altri sistemi che li usano.
OpenAI, Anthropic e Perplexity non citano llms.txt in ciò che pubblicano sui loro crawler (OpenAI, Anthropic, Perplexity). Descrivono robots.txt, e nient’altro, come il modo in cui un sito dice loro cosa leggere.
Eppure tutte e tre pubblicano un proprio llms.txt, sulla documentazione per sviluppatori (OpenAI, Anthropic, Perplexity). È lì che il formato funziona: uno sviluppatore manda un assistente di programmazione sulla documentazione, e il file gli dà la mappa. È un file per uno strumento di IA che qualcuno ha mandato sul tuo sito, non un segnale che spinge un assistente a scegliere il tuo sito.
Chi ce l’ha
Nel nostro studio su 23.411 siti aziendali in Europa e negli Stati Uniti, il 25,9% aveva un llms.txt. La maggior parte non l’ha scelto: ce l’avevano il 94,0% dei siti Shopify e l’89,6% dei siti Wix, contro il 9,3% su Squarespace, e in un campione di 397 file almeno il 46% risultava creato da un plugin SEO o dalla piattaforma.
Un file creato in automatico spesso elenca l’informativa sulla privacy e il carrello e lascia fuori ciò che l’azienda vende. Non fa danni, ma non è una descrizione dell’azienda scritta da qualcuno.
Ti serve?
Sì, se ti costa poco, e senza aspettarti troppo. È un file e un’ora, non danneggia nulla, ed è utile agli strumenti di IA che lo leggono: assistenti di programmazione, agenti di ricerca e chiunque mandi un modello sul tuo sito.
Non aspettarti che ti faccia citare. Niente di ciò che abbiamo trovato indica che ChatGPT, Claude, Perplexity o le risposte IA di Google lo usino per decidere quali marchi consigliare. Quello che usano è ciò che dice una pagina quando la loro ricerca la trova. Prima conviene:
- Far entrare i crawler di ricerca. OAI-SearchBot, Claude-SearchBot, PerplexityBot e Googlebot devono essere ammessi nel robots.txt e non respinti dal firewall (quali crawler ammettere).
- Mettere il testo nell’HTML. Una pagina il cui testo appare solo dopo gli script può essere letta come vuota.
- Avere una pagina per ogni cosa su cui ti fanno domande: cosa fai, per chi, a che prezzo, rispetto a chi. È ciò che un assistente cita.
Se tieni un llms.txt, scrivilo tu: una frase onesta su cosa fai, poi le pagine di servizi, prezzi e contatti, con una nota semplice per ciascuna. Se il tuo l’ha creato un plugin, aprilo e controlla che elenchi ciò che vendi.
Controlla il tuo
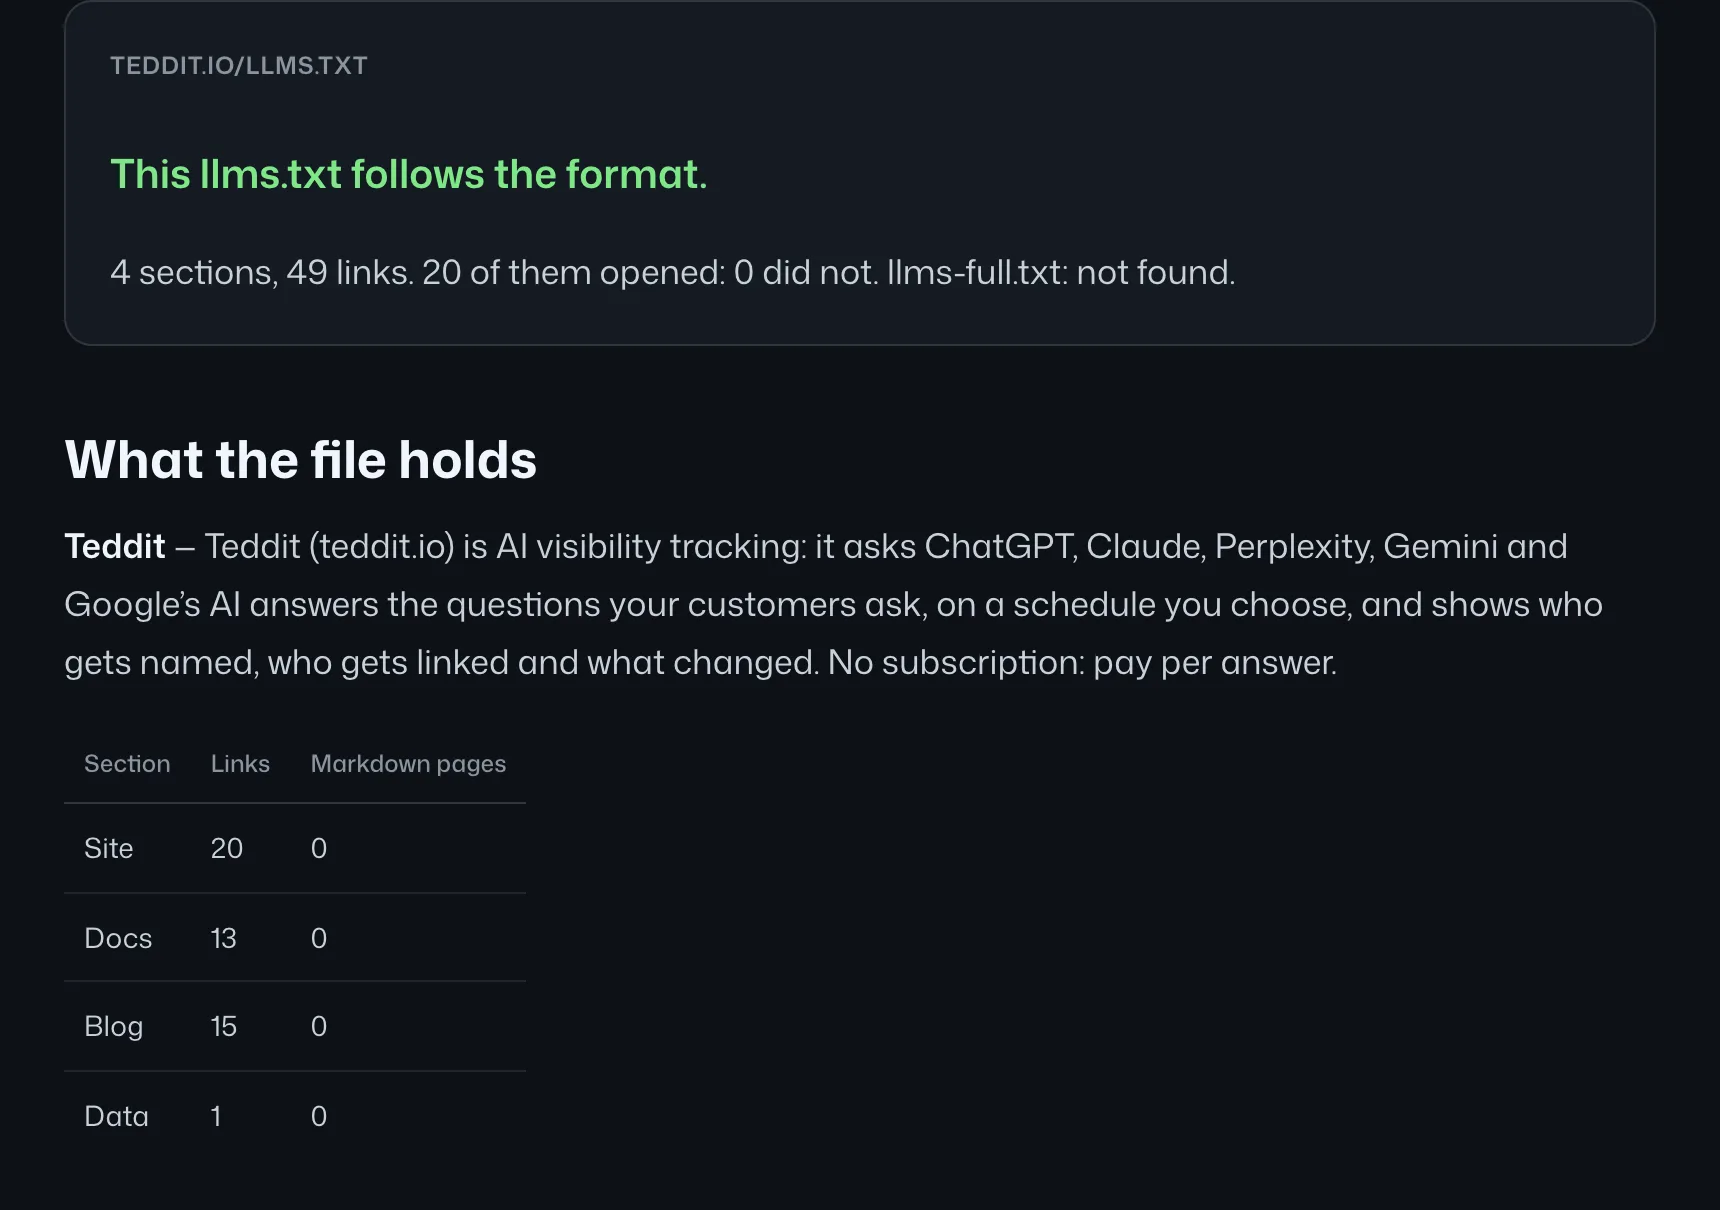
Il nostro validatore llms.txt gratuito confronta il file di un sito con il formato, apre i suoi link, cerca llms-full.txt e scrive una prima bozza quando il file manca. Il controllo dei crawler IA fa la parte che conta di più: se ogni crawler IA può leggere il sito. Nessuno dei due chiede un account.
Fonti
- The /llms.txt file, Jeremy Howard: la proposta e il suo formato.
- Google’s guide to optimizing for generative AI features on Google Search, Google Search Central: llms.txt non è usato dalla Ricerca Google.
- Search Central updates, Google: la nota di giugno 2026 sui file llms.txt.
- Overview of OpenAI crawlers, OpenAI.
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic.
- Perplexity crawlers, Perplexity.
- I llms.txt della documentazione per sviluppatori di OpenAI, Anthropic e Perplexity.
- Abbiamo verificato 23,411 siti aziendali. Quasi tutti lasciano entrare l’IA, Teddit: quanti siti hanno un llms.txt, e chi l’ha creato.