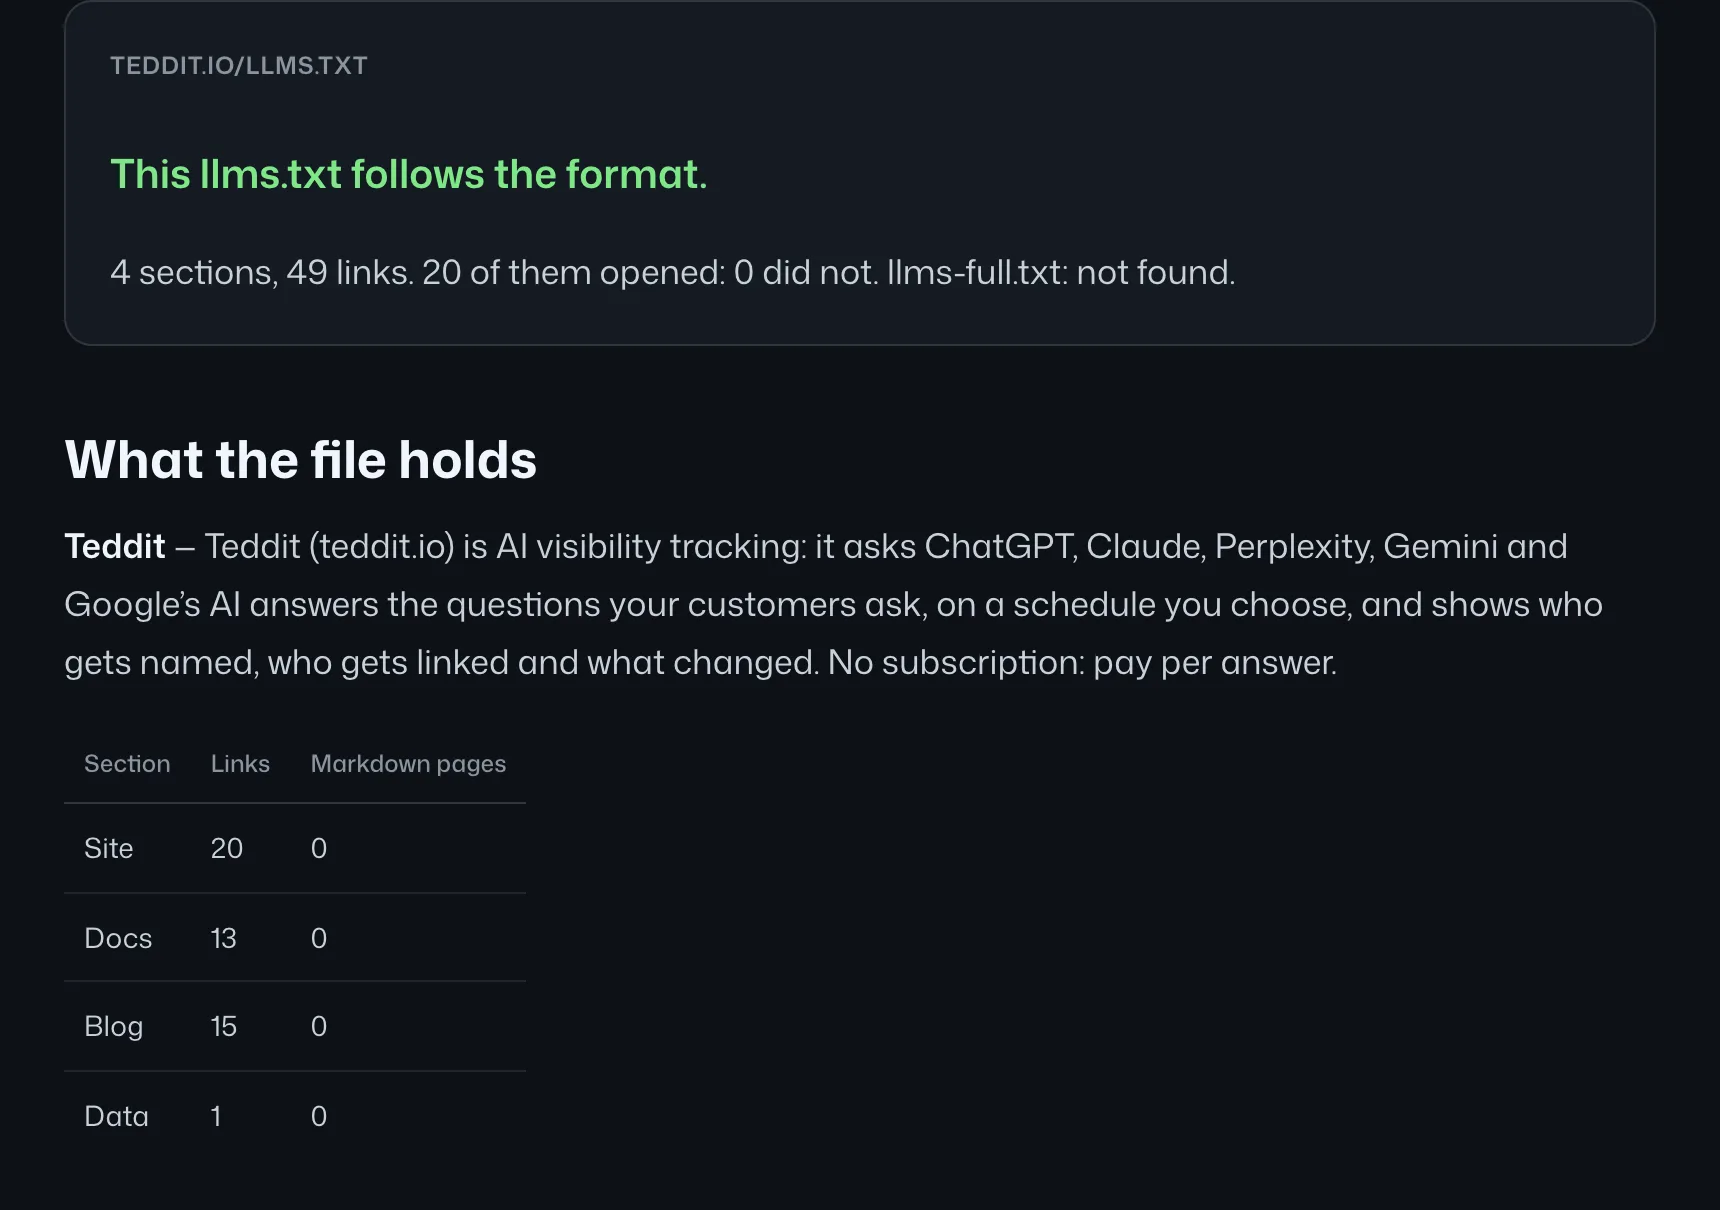
Qué es llms.txt
llms.txt lo propuso Jeremy Howard en septiembre de 2024. Es un archivo Markdown sencillo servido en /llms.txt, pensado para los modelos de lenguaje que leen un sitio cuando alguien les pregunta por él: una descripción breve del sitio y la lista de sus páginas clave, para que un modelo no tenga que atravesar menús, scripts y avisos de cookies para encontrarlas.
El formato es pequeño. Solo la primera línea es obligatoria:
- Un título (
# Nombre): el sitio o el proyecto. - Un resumen en cita (
>): qué es, en una o dos frases. - Notas en párrafos normales: lo que un lector debe saber primero.
- Secciones de enlaces bajo
## Títulos, un[nombre](url): notapor línea. Una sección## Optionalreúne lo que se puede saltar.
El nuestro, abreviado:
# Teddit

> Teddit (teddit.io) is AI visibility tracking: it asks ChatGPT, Claude,
> Perplexity, Gemini and Google's AI answers the questions your customers ask,
> and shows who gets named, who gets linked and what changed.

Teddit is not related to the open-source Reddit front-end also called Teddit.

## Site

- [Pricing](https://teddit.io/pricing): pay per answer, no subscription
- [AI crawler check](https://teddit.io/tools/ai-crawler-check): free check of robots.txt for AI crawlers

## Optional

- [Terms of Service](https://teddit.io/terms)
La propuesta sugiere también una copia en Markdown de cada página en la misma dirección, con .md al final. llms-full.txt, todo el sitio o toda la documentación en un solo archivo, no está en la propuesta: es una convención que creció a su alrededor, sobre todo en sitios de documentación.
Quién pidió el nuestro: 18 días de registros del servidor
teddit.io sirve un llms.txt que se construye con el sitio: un resumen y luego cada página con su tema. Nuestro servidor registra cada petición de un rastreador (no las de las personas). Del 16 de octubre al 4 de noviembre de 2026 contamos lo que pidió el rastreador de cada empresa de IA: todo, y luego robots.txt, el sitemap y llms.txt.
| Rastreador | Operador | Peticiones | robots.txt | Sitemap | llms.txt |
|---|---|---|---|---|---|
ClaudeBot | Anthropic | 1586 | 225 | 224 | 1 |
Googlebot | 1433 | 158 | 9 | 0 | |
Amazonbot | Amazon | 841 | 0 | 2 | 0 |
OAI-SearchBot | OpenAI | 515 | 46 | 0 | 0 |
meta-externalagent | Meta | 512 | 0 | 1 | 0 |
GoogleOther | 426 | 3 | 0 | 1 | |
bingbot | Microsoft | 421 | 14 | 5 | 0 |
PerplexityBot | Perplexity | 343 | 19 | 2 | 1 |
ChatGPT-User | OpenAI | 333 | 1 | 1 | 0 |
cohere | Cohere | 307 | 1 | 0 | 0 |
CCBot | Common Crawl | 302 | 0 | 1 | 0 |
Applebot | Apple | 300 | 5 | 0 | 0 |
Bytespider | ByteDance | 298 | 0 | 1 | 0 |
DuckAssistBot | DuckDuckGo | 293 | 3 | 2 | 0 |
GPTBot | OpenAI | 285 | 0 | 6 | 1 |
Perplexity-User | Perplexity | 270 | 1 | 1 | 0 |
MistralAI-User | Mistral | 15 | 2 | 0 | 0 |
Claude-User | Anthropic | 9 | 2 | 0 | 0 |
Claude-SearchBot | Anthropic | 1 | 0 | 0 | 0 |
| Los 19 rastreadores | 8490 | 480 | 255 | 4 | |
Cuatro peticiones de 8.490: GPTBot una vez el 16 de octubre, PerplexityBot el 30 de octubre, GoogleOther y ClaudeBot el 1 de noviembre. Todos recibieron el archivo. Ninguno volvió a pedirlo. En los mismos días, los mismos rastreadores pidieron robots.txt 480 veces y el sitemap 255 veces, y leyeron 844 direcciones distintas.
Los rastreadores que descargan páginas mientras un asistente responde a alguien (OAI-SearchBot, ChatGPT-User, Perplexity-User, Claude-User) hicieron entre todos 1.127 peticiones y nunca pidieron llms.txt. Los cuatro que sí lo hicieron recogen páginas en masa, y lo trataron como una página más.
Qué dicen las empresas
Google es la única que lo dice abiertamente. Su guía de las funciones de IA de Google pone llms.txt entre las cosas que no hacen falta: la Búsqueda de Google no usa estos archivos, y tener uno no ayuda ni perjudica a un sitio en la Búsqueda de Google, AI Overviews y AI Mode incluidos. Google añadió esa frase en junio de 2026 (novedades de Search Central), aclarando que se pueden mantener para otros sistemas que los usen.
OpenAI, Anthropic y Perplexity no mencionan llms.txt en lo que publican sobre sus rastreadores (OpenAI, Anthropic, Perplexity). Describen robots.txt, y nada más, como la forma en que un sitio les dice qué leer.
Aun así, las tres publican su propio llms.txt, en su documentación para desarrolladores (OpenAI, Anthropic, Perplexity). Ahí es donde el formato funciona: un desarrollador manda un asistente de programación a la documentación, y el archivo le da el mapa. Es un archivo para una herramienta de IA que alguien ha enviado a tu sitio, no una señal que haga que un asistente elija tu sitio.
Quién lo tiene
En nuestro estudio de 23.411 sitios de empresas en Europa y Estados Unidos, el 25,9 % tenía un llms.txt. La mayoría no lo eligió: lo tenían el 94,0 % de los sitios en Shopify y el 89,6 % de los de Wix, frente al 9,3 % en Squarespace, y en una muestra de 397 archivos al menos el 46 % figuraba como creado por un plugin de SEO o por la plataforma.
Un archivo creado por defecto suele listar la política de privacidad y el carrito y dejar fuera lo que vende la empresa. No hace daño, pero no es una descripción de la empresa que alguien haya escrito.
¿Deberías tener uno?
Sí, si te cuesta poco, y sin esperar demasiado. Es un archivo y una hora, no perjudica nada y es útil para las herramientas de IA que lo leen: asistentes de programación, agentes de investigación y cualquiera que mande un modelo a tu sitio.
No esperes que te haga aparecer. Nada de lo que encontramos indica que ChatGPT, Claude, Perplexity o las respuestas de IA de Google lo usen para decidir qué marcas recomendar. Lo que usan es lo que dice una página cuando su búsqueda la encuentra. Conviene hacer antes:
- Deja entrar a los rastreadores de búsqueda. OAI-SearchBot, Claude-SearchBot, PerplexityBot y Googlebot deben estar permitidos en robots.txt y no ser rechazados por tu cortafuegos (qué rastreadores permitir).
- Pon el texto en el HTML. Una página cuyo texto solo aparece después de ejecutar sus scripts puede leerse como vacía.
- Ten una página para cada cosa por la que te preguntan: qué haces, para quién, a qué precio, frente a quién. Eso es lo que cita un asistente.
Si mantienes un llms.txt, escríbelo tú: una frase honesta sobre lo que haces y luego tus páginas de servicios, precios y contacto, con una nota sencilla en cada una. Si lo hizo un plugin, ábrelo y comprueba que lista lo que vendes.
Comprueba el tuyo
Nuestro validador de llms.txt gratuito compara el archivo de un sitio con el formato, abre sus enlaces, busca llms-full.txt y redacta un primer archivo cuando no hay ninguno. La comprobación de rastreadores de IA hace la parte que más importa: si cada rastreador de IA puede leer el sitio. Ninguno de los dos pide cuenta.
Fuentes
- The /llms.txt file, Jeremy Howard: la propuesta y su formato.
- Google’s guide to optimizing for generative AI features on Google Search, Google Search Central: la Búsqueda de Google no usa llms.txt.
- Search Central updates, Google: la nota de junio de 2026 sobre los archivos llms.txt.
- Overview of OpenAI crawlers, OpenAI.
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic.
- Perplexity crawlers, Perplexity.
- Los llms.txt de la documentación para desarrolladores de OpenAI, Anthropic y Perplexity.
- Comprobamos 23,411 sitios web de empresas. Casi todos dejan entrar a la IA, Teddit: cuántos sitios tienen un llms.txt, y quién lo hizo.