Paga por respuesta. Sin suscripción.
Sin plan mensual, sin asientos, sin funciones detrás de un nivel. Recargas un saldo y pagas por respuesta de IA, desde menos de un céntimo. Un análisis es prompts × asistentes, ves su precio antes de ejecutarlo, y la cola cuesta menos.
La misma estimación antes de cada análisis
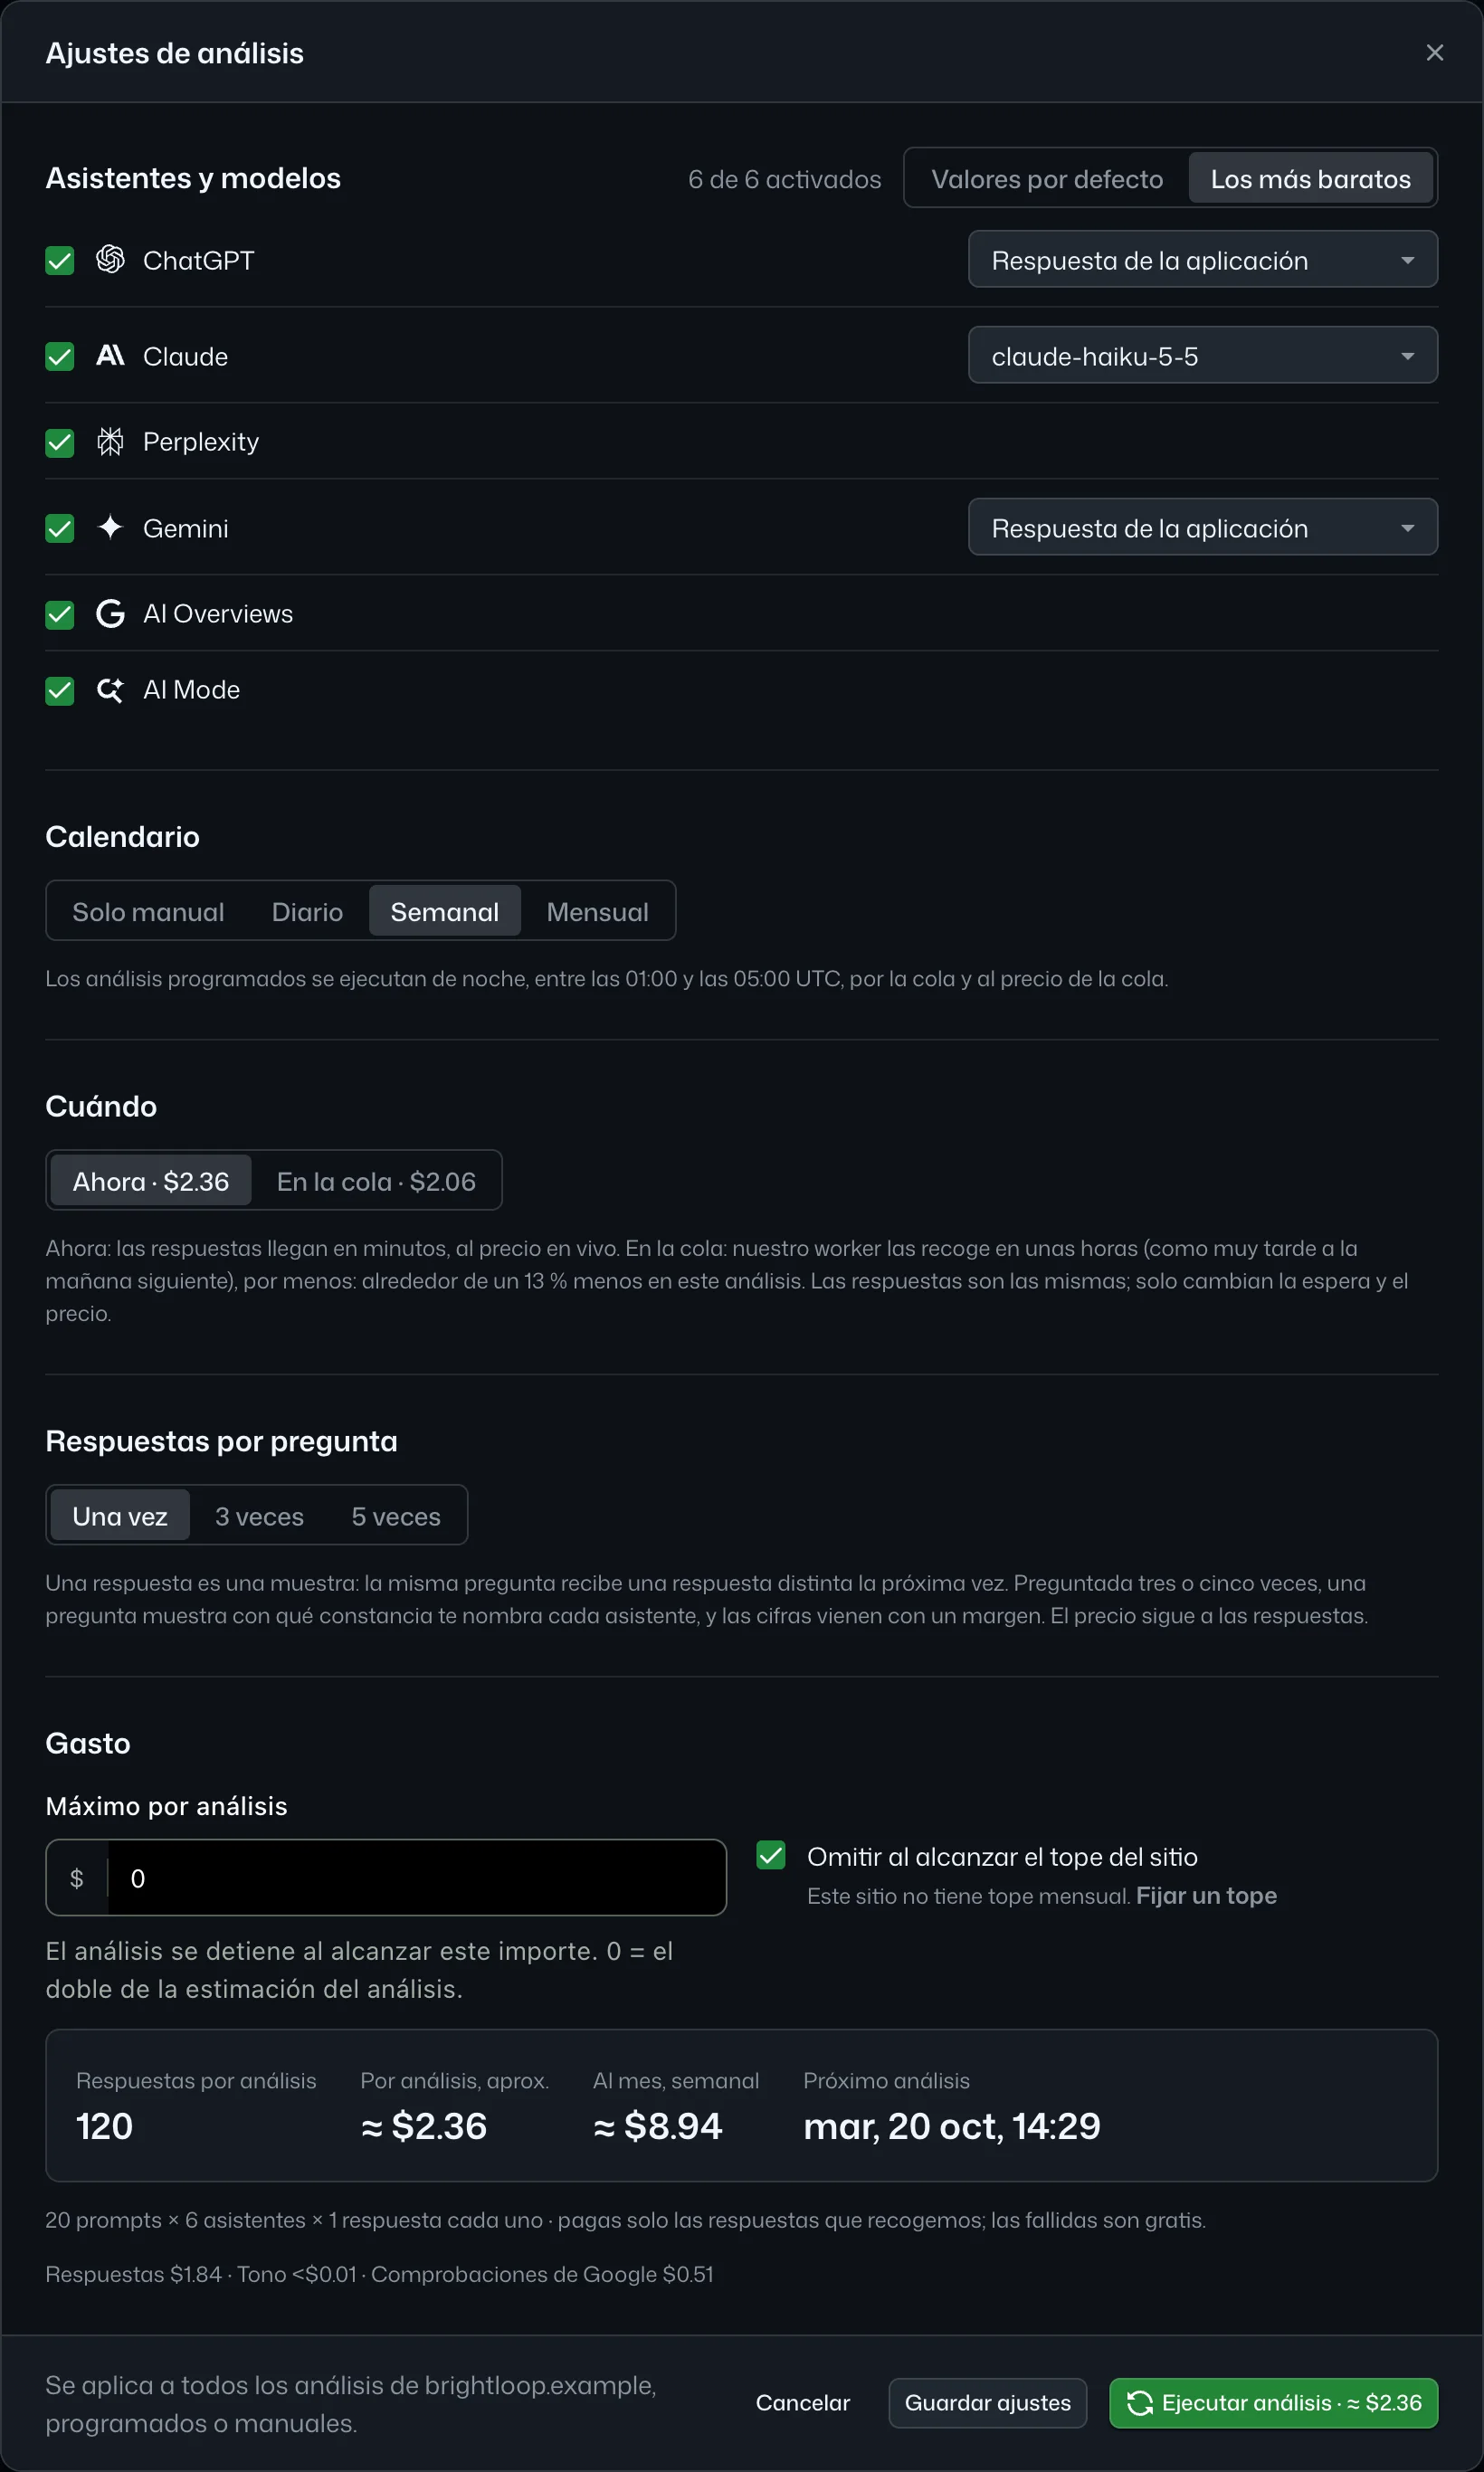
Los ajustes de análisis muestran cada asistente con su modelo y el precio de una respuesta, cuántas respuestas por pregunta, ahora o en la cola, el calendario y los límites. El total se actualiza con cada cambio, y no se pregunta nada a ningún asistente hasta que pulses Ejecutar.
- Un límite por análisis y un tope mensual por sitio
- Los análisis se detienen cuando se agota el saldo
- Cada análisis en la página Gasto, con sus respuestas y su precio
Lo que cuesta el mes de una agencia
Cinco clientes, 30 prompts cada uno, cuatro asistentes (ChatGPT, Claude, Perplexity, Gemini), analizados cada semana: 150 prompts, 600 respuestas por análisis, unas 2598 respuestas al mes. Lo que cuesta depende de los modelos mucho más que de cualquier otra cosa:
| Modelos | Por prompt, cuatro respuestas | Por análisis | Al mes |
|---|---|---|---|
| Los más baratosLas respuestas tal como las muestran las aplicaciones de ChatGPT y Gemini, el Claude más pequeño, el sonar de Perplexity. Donde empieza un sitio nuevo. | $0.053 | $7.98 | $34.55 |
| Gama mediaUn modelo pequeño y rápido de cada asistente. | $0.359 | $53.78 | $233 |
| Modelos insigniaEl mejor modelo de cada asistente, a un clic en los ajustes de análisis. | $0.672 | $101 | $436 |
- Los más baratos. Las respuestas tal como las muestran las aplicaciones de ChatGPT y Gemini, el Claude más pequeño, el sonar de Perplexity. Donde empieza un sitio nuevo.
- Gama media. Un modelo pequeño y rápido de cada asistente.
- Modelos insignia. El mejor modelo de cada asistente, a un clic en los ajustes de análisis.
Un sitio nuevo empieza con los modelos más baratos; los modelos insignia están a un clic, y el precio de cada elección se muestra antes del análisis. Cada cliente es un sitio con sus propios prompts, competidores y tope mensual, y no hay cuota por sitio ni por asiento. Las herramientas por suscripción de esta categoría venden cupos de prompts y suelen cobrar por marca; sus precios públicos, con fuentes y fechas, están en las páginas de comparación.
- ChatGPT, Claude, Perplexity y Gemini con búsqueda web activada, más Google AI Overviews y AI Mode
- Cada respuesta guardada como texto, con las marcas nombradas, las páginas citadas y las búsquedas realizadas
- Panel, tendencias, competidores, páginas y tono
- Buyer personas
- Enlaces de informe para clientes, firmados con tu nombre y logotipo, imprimibles en PDF
- Servidor MCP y API REST con herramientas de lectura y escritura
- Una, tres o cinco respuestas por pregunta; análisis ahora mismo o por la cola, por menos
- Un límite por análisis y un tope mensual por sitio
- Importación y exportación CSV de prompts, varias categorías por prompt
- Miembros con roles, limitados a algunos sitios si quieres
- Una factura por cada pago con tarjeta y un extracto mensual
Preguntas sobre precios
¿Cuánto cuesta un análisis?
Un análisis hace cada prompt activo a cada asistente activado, así que son prompts × asistentes respuestas (× 3 o × 5 si haces cada pregunta varias veces). Cada respuesta tiene un precio que depende del asistente y del modelo, desde menos de un céntimo por la respuesta tal como la muestra la aplicación de ChatGPT hasta unos treinta céntimos por un modelo insignia. El total se muestra antes de empezar, ahora mismo y por la cola, y solo se cobran las respuestas recogidas.
¿Qué es la cola, y por qué es más barata?
Un análisis en cola espera a nuestro worker en lugar de ejecutarse en cuanto pulsas el botón: las respuestas llegan en unas horas, como muy tarde a la mañana siguiente. Los análisis programados siempre funcionan así. Recoger respuestas en bloque nos cuesta menos, y parte de ese ahorro se descuenta del precio de cada respuesta recogida por la cola. La estimación muestra ambos precios antes de que elijas.
¿Hay una herramienta de visibilidad en IA sin suscripción mensual?
Teddit no la tiene. Recargas un saldo prepagado y pagas por respuesta de IA que recogen tus análisis, a los precios de esta página. Nada se renueva y no se cobra nada mientras no analices.
¿Hay plan gratuito o prueba?
No. No hay suscripción, ni plan gratuito, ni prueba. Recargas un saldo prepagado, desde 20 $, y pagas lo que consumen tus análisis a los precios de esta página: las respuestas, más los dos pequeños extras descritos abajo. La comprobación de visibilidad gratuita de la página de inicio no cuesta nada y no necesita cuenta.
¿Puedo hacer cada pregunta más de una vez?
Sí: una, tres o cinco respuestas por pregunta y asistente, en los ajustes de análisis. Una respuesta es una muestra; tres o cinco dan a cada proporción un margen legible, y los cuadros y la tendencia los usan ambos. Las respuestas adicionales cuestan un poco menos que la primera, y la estimación muestra el total.
¿Cuál es la diferencia entre los modelos de un asistente?
Cada asistente ofrece un modelo insignia y otros más pequeños. Un modelo más grande suele escribir una respuesta más completa y cuesta más por respuesta. Eliges el modelo por asistente en los ajustes de análisis, y el precio se actualiza al cambiar.
¿Qué es la opción «respuesta de la aplicación» para ChatGPT y Gemini?
La respuesta tal como la aplicación de ChatGPT o Gemini se la muestra a alguien sin sesión iniciada, en lugar de una respuesta de uno de los modelos que elijas. Cuesta mucho menos por respuesta que los modelos, y aún menos en la cola.
¿Qué son AI Overviews y AI Mode?
Las propias respuestas de IA de Google: AI Overviews, la respuesta de IA sobre los resultados de búsqueda, y AI Mode, la búsqueda con IA de Google. Teddit las lee de Google, al momento o por la cola por menos. A menudo Google no muestra ningún AI Overview para una búsqueda; eso también es un resultado, una respuesta que no te nombra, y se cobra como una respuesta.
¿Puedo evitar que un análisis cueste demasiado?
Sí, de tres formas. «Máximo por análisis» detiene un análisis cuando ha gastado ese importe; dejado en 0, un análisis se detiene al doble de su estimación. Un tope mensual en un sitio detiene sus análisis cuando el gasto del mes alcanza el tope. Y un análisis nunca gasta más de lo que hay en el saldo: se detiene cuando se agota.
¿Y si solo analizo manualmente?
Entonces no se ejecuta nada ni se cobra nada hasta que pulses Ejecutar análisis. No hay mínimo mensual.
¿Pago por las respuestas fallidas?
No. Un análisis se cobra solo por las respuestas que recoge. Una respuesta que falla, por ejemplo por tiempo de espera, no cuesta nada, y un cargo hecho por error vuelve al saldo.
¿Quién procesa el pago?
Paddle.com, nuestro revendedor en línea y Merchant of Record. Gestiona el pago, el IVA y los impuestos sobre ventas, y envía el recibo; una empresa puede introducir su NIF-IVA al pagar. Los precios no incluyen impuestos: el IVA o el impuesto sobre ventas, donde aplique, se añade al pagar, y el importe completo va al saldo. La recarga mínima es de 20 $. El saldo no caduca; las recargas no son reembolsables (ver la política de reembolsos). La factura de cada pago con tarjeta y un extracto mensual están en la página Gasto.
¿Con qué modelos empiezan los sitios nuevos?
La opción más barata de cada asistente: la respuesta tal como la muestra la aplicación de ChatGPT o Gemini, el Claude más pequeño, el sonar de Perplexity y las respuestas de Google. Cambia cualquiera de ellos, o elige el modelo insignia de cada asistente, antes de un análisis; el precio cambia con la elección y se muestra antes de ejecutarlo.
¿Qué incluye el precio de una respuesta?
La respuesta del asistente, las búsquedas web que realiza y su lectura para detectar marcas, enlaces e idioma. A un análisis se añaden dos extras: evaluar el tono de las respuestas que te nombran (unos céntimos por cada cien respuestas) y comprobar la posición en Google de las búsquedas de los asistentes (unos 0,0036 $ por búsqueda, cada búsqueda una vez a la semana). La estimación antes de cada análisis incluye ambos, y cada respuesta se cobra por lo que realmente consumió. Leer tus informes, compartirlos, el servidor MCP y la API no cuestan nada.