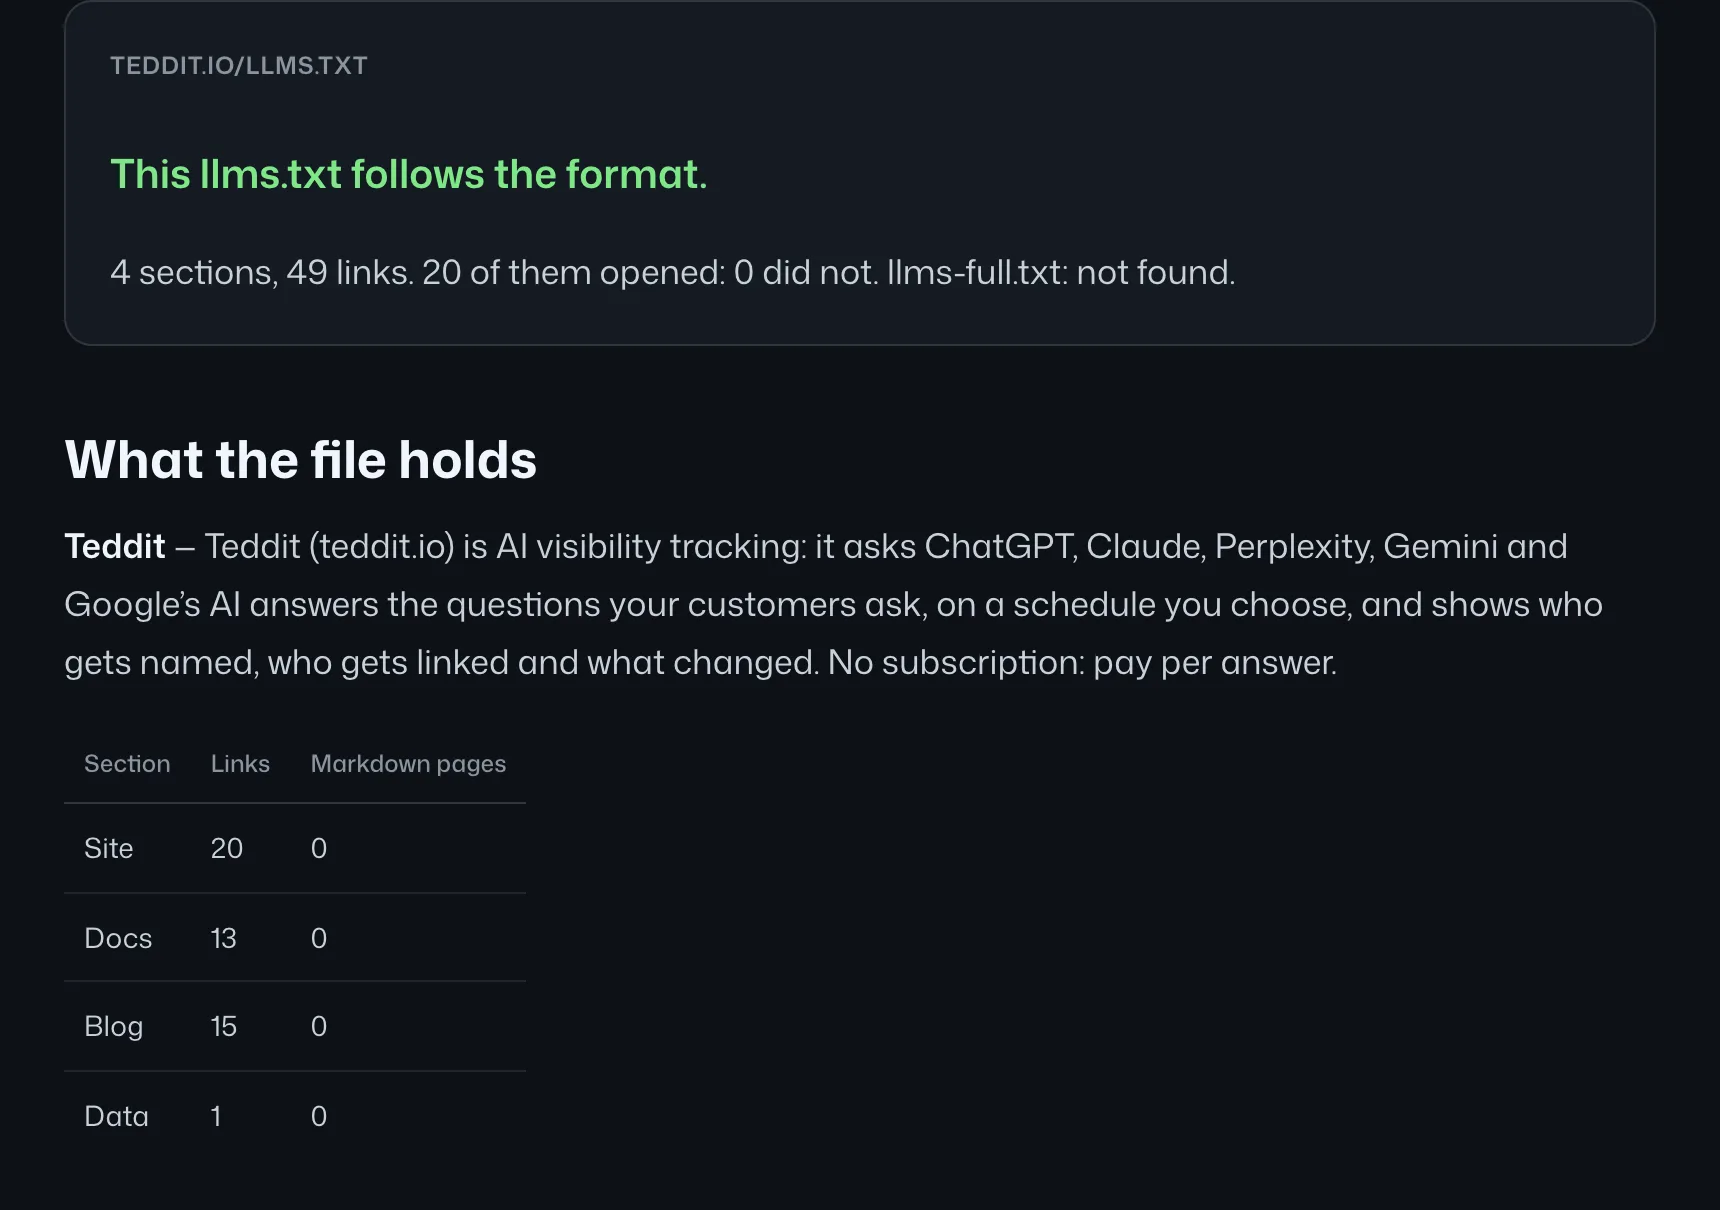
Was llms.txt ist
llms.txt wurde im September 2024 von Jeremy Howard vorgeschlagen. Es ist eine einfache Markdown-Datei unter /llms.txt, gedacht für Sprachmodelle, die eine Website lesen, wenn jemand sie danach fragt: eine kurze Beschreibung der Website und eine Liste ihrer wichtigsten Seiten, damit ein Modell sich nicht erst durch Menüs, Skripte und Cookie-Banner arbeiten muss.
Das Format ist klein. Nur die erste Zeile ist Pflicht:
- Ein Titel (
# Name): die Website oder das Projekt. - Eine Zusammenfassung als Zitat (
>): was es ist, in ein, zwei Sätzen. - Hinweise in normalen Absätzen: was ein Leser zuerst wissen sollte.
- Abschnitte mit Links unter
## Überschriften, ein[Name](URL): Notizpro Zeile. Ein Abschnitt## Optionalenthält, was man überspringen kann.
Unsere, gekürzt:
# Teddit

> Teddit (teddit.io) is AI visibility tracking: it asks ChatGPT, Claude,
> Perplexity, Gemini and Google's AI answers the questions your customers ask,
> and shows who gets named, who gets linked and what changed.

Teddit is not related to the open-source Reddit front-end also called Teddit.

## Site

- [Pricing](https://teddit.io/pricing): pay per answer, no subscription
- [AI crawler check](https://teddit.io/tools/ai-crawler-check): free check of robots.txt for AI crawlers

## Optional

- [Terms of Service](https://teddit.io/terms)
Der Vorschlag empfiehlt außerdem eine Markdown-Fassung jeder Seite unter derselben Adresse mit angehängtem .md. llms-full.txt, die ganze Website oder Dokumentation in einer Datei, steht nicht im Vorschlag; das ist eine Konvention, die sich drumherum gebildet hat, vor allem auf Dokumentations-Websites.
Wer unsere abgerufen hat: 18 Tage Server-Logs
teddit.io liefert eine llms.txt, die mit der Website gebaut wird: eine Zusammenfassung, dann jede Seite mit ihrem Thema. Unser Server protokolliert jede Anfrage eines Crawlers (nicht die von Menschen). Vom 16. Oktober bis 4. November 2026 haben wir gezählt, was die Crawler der KI-Unternehmen abgerufen haben: alles, dann robots.txt, die Sitemap und llms.txt.
| Crawler | Betreiber | Anfragen | robots.txt | Sitemap | llms.txt |
|---|---|---|---|---|---|
ClaudeBot | Anthropic | 1.586 | 225 | 224 | 1 |
Googlebot | 1.433 | 158 | 9 | 0 | |
Amazonbot | Amazon | 841 | 0 | 2 | 0 |
OAI-SearchBot | OpenAI | 515 | 46 | 0 | 0 |
meta-externalagent | Meta | 512 | 0 | 1 | 0 |
GoogleOther | 426 | 3 | 0 | 1 | |
bingbot | Microsoft | 421 | 14 | 5 | 0 |
PerplexityBot | Perplexity | 343 | 19 | 2 | 1 |
ChatGPT-User | OpenAI | 333 | 1 | 1 | 0 |
cohere | Cohere | 307 | 1 | 0 | 0 |
CCBot | Common Crawl | 302 | 0 | 1 | 0 |
Applebot | Apple | 300 | 5 | 0 | 0 |
Bytespider | ByteDance | 298 | 0 | 1 | 0 |
DuckAssistBot | DuckDuckGo | 293 | 3 | 2 | 0 |
GPTBot | OpenAI | 285 | 0 | 6 | 1 |
Perplexity-User | Perplexity | 270 | 1 | 1 | 0 |
MistralAI-User | Mistral | 15 | 2 | 0 | 0 |
Claude-User | Anthropic | 9 | 2 | 0 | 0 |
Claude-SearchBot | Anthropic | 1 | 0 | 0 | 0 |
| Alle 19 Crawler | 8.490 | 480 | 255 | 4 | |
Vier Anfragen von 8.490: GPTBot einmal am 16. Oktober, PerplexityBot am 30. Oktober, GoogleOther und ClaudeBot am 1. November. Jeder bekam die Datei. Keiner kam dafür wieder. In denselben Tagen fragten dieselben Crawler 480-mal nach robots.txt und 255-mal nach der Sitemap und lasen 844 verschiedene Adressen.
Die Crawler, die Seiten abrufen, während ein Assistent jemandem antwortet (OAI-SearchBot, ChatGPT-User, Perplexity-User, Claude-User), stellten zusammen 1.127 Anfragen und fragten nie nach llms.txt. Die vier, die es taten, sammeln Seiten in großen Mengen und behandelten die Datei als eine Seite mehr.
Was die Unternehmen sagen
Google sagt es als Einziges ausdrücklich. Sein Leitfaden zu Googles KI-Funktionen zählt llms.txt zu den Dingen, die man nicht braucht: Die Google-Suche nutzt diese Dateien nicht, und eine zu haben hilft oder schadet einer Website in der Google-Suche nicht, AI Overviews und AI Mode eingeschlossen. Google hat diese Formulierung im Juni 2026 ergänzt (Search Central Updates) und dazu gesagt, dass man solche Dateien für andere Systeme, die sie nutzen, gern behalten kann.
OpenAI, Anthropic und Perplexity erwähnen llms.txt nicht in dem, was sie über ihre Crawler veröffentlichen (OpenAI, Anthropic, Perplexity). Sie beschreiben robots.txt, und nichts sonst, als den Weg, auf dem eine Website ihnen sagt, was sie lesen dürfen.
Trotzdem veröffentlichen alle drei eine eigene llms.txt, auf ihrer Entwicklerdokumentation (OpenAI, Anthropic, Perplexity). Dort funktioniert das Format: Ein Entwickler schickt einen Coding-Assistenten auf die Doku, und die Datei gibt ihm die Karte. Es ist eine Datei für ein KI-Werkzeug, das jemand auf Ihre Website geschickt hat, kein Signal, das einen Assistenten dazu bringt, Ihre Website zu wählen.
Wer eine hat
In unserer Untersuchung von 23.411 Unternehmenswebsites in Europa und den USA hatten 25,9 % eine llms.txt. Die meisten haben sich nicht dafür entschieden: 94,0 % der Shopify-Websites und 89,6 % der Wix-Websites hatten eine, gegenüber 9,3 % bei Squarespace, und in einer Stichprobe von 397 Dateien waren mindestens 46 % als Werk eines SEO-Plugins oder der Plattform gekennzeichnet.
Eine automatisch erzeugte Datei listet oft die Datenschutzerklärung und den Warenkorb und lässt weg, was das Unternehmen verkauft. Sie schadet nicht, aber sie ist keine Beschreibung des Unternehmens, die jemand geschrieben hat.
Sollten Sie eine haben?
Ja, wenn es Sie wenig kostet, und mit bescheidenen Erwartungen. Es ist eine Datei und eine Stunde, es schadet nichts, und es hilft den KI-Werkzeugen, die sie lesen: Coding-Assistenten, Recherche-Agenten und allen, die ein Modell auf Ihre Website ansetzen.
Erwarten Sie nicht, dass Sie dadurch genannt werden. Nichts, was wir gefunden haben, deutet darauf hin, dass ChatGPT, Claude, Perplexity oder Googles KI-Antworten sie nutzen, um zu entscheiden, welche Marken sie empfehlen. Was sie nutzen, ist das, was auf einer Seite steht, wenn ihre Suche sie findet. Lohnt sich zuerst:
- Lassen Sie die Such-Crawler herein. OAI-SearchBot, Claude-SearchBot, PerplexityBot und Googlebot müssen in der robots.txt erlaubt sein und dürfen nicht von Ihrer Firewall abgewiesen werden (welche Crawler Sie zulassen sollten).
- Bringen Sie den Text ins HTML. Eine Seite, deren Text erst nach ihren Skripten erscheint, wird womöglich als leer gelesen.
- Haben Sie eine Seite für alles, wonach man Sie fragt: was Sie tun, für wen, zu welchem Preis, im Vergleich zu wem. Das zitiert ein Assistent.
Wenn Sie eine llms.txt pflegen, schreiben Sie sie selbst: ein ehrlicher Satz dazu, was Sie tun, dann Ihre Leistungs-, Preis- und Kontaktseiten mit einer einfachen Notiz zu jeder. Hat ein Plugin Ihre erstellt, öffnen Sie sie und prüfen Sie, ob sie aufführt, was Sie verkaufen.
Prüfen Sie Ihre
Unser kostenloser llms.txt-Checker prüft die Datei einer Website gegen das Format, öffnet ihre Links, sucht nach llms-full.txt und entwirft eine erste Datei, wenn es keine gibt. Der KI-Crawler-Check erledigt den wichtigeren Teil: ob jeder KI-Crawler die Website überhaupt lesen darf. Beide brauchen kein Konto.
Quellen
- The /llms.txt file, Jeremy Howard: der Vorschlag und sein Format.
- Google’s guide to optimizing for generative AI features on Google Search, Google Search Central: llms.txt wird von der Google-Suche nicht genutzt.
- Search Central updates, Google: der Hinweis zu llms.txt vom Juni 2026.
- Overview of OpenAI crawlers, OpenAI.
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic.
- Perplexity crawlers, Perplexity.
- Die llms.txt der Entwicklerdokumentation von OpenAI, Anthropic und Perplexity.
- Wir haben 23.411 Unternehmenswebsites geprüft. Fast alle lassen KI herein, Teddit: wie viele Websites eine llms.txt haben und wer sie erstellt hat.